Resposta rápida: Observabilidade de data center é a capacidade de explicar o que está acontecendo na infraestrutura de uma instalação a partir dos dados que ela emite: métricas, logs e traces, mais a telemetria da camada física, como consumo de energia, temperatura de entrada e níveis ópticos de recepção. O monitoramento diz que algo está errado. A observabilidade diz por quê, e em qual rack, dispositivo e porta um técnico precisa mexer.
A maioria das equipes de operações não sofre com falta de dados. Switches exportam contadores de interface, PDUs reportam amperes por tomada, o sistema de gerenciamento predial registra cada mudança nas válvulas de água gelada e o sistema de tickets guarda anos de notas de incidentes. Observabilidade de data center é fazer esses dados responderem a perguntas para as quais ninguém escreveu um alerta, rápido o bastante para mudar o desfecho de um incidente.
Este guia é para líderes de infraestrutura, gerentes de operações e equipes de SRE que constroem ou reconstroem uma stack de telemetria. Ele cobre os três tipos clássicos de sinal, onde o OpenTelemetry se encaixa e por que a camada física é a parte que a maioria dos programas de observabilidade erra.
Escrevemos do lado de campo. Nossos técnicos são as pessoas que aparecem quando os painéis ficam vermelhos, então vemos onde os dados estavam certos e onde mandaram alguém para o rack errado.
O que é observabilidade de data center?
Observabilidade de data center é a prática de instrumentar cada camada de uma instalação para que os operadores possam raciocinar sobre seu estado interno apenas a partir de suas saídas. O conceito veio da teoria de controle e foi popularizado por equipes de software. Os data centers acrescentam uma dimensão física com a qual a maioria das equipes de software nunca lida.
Uma definição prática: observabilidade de data center é a capacidade de inferir a saúde e o comportamento de sistemas de instalação, hardware e rede a partir de sua telemetria, correlacionada entre camadas e vinculada a registros físicos precisos, para que as equipes possam diagnosticar problemas que não previram.
O projeto OpenTelemetry resume bem a ideia geral, definindo observabilidade como “a capacidade de entender o estado interno de um sistema examinando suas saídas”.
Monitoramento vs. observabilidade
O monitoramento executa verificações que você definiu com antecedência. A UPS está na bateria? O link está ativo? A temperatura de entrada está acima do limite? Essas verificações são necessárias e captam as falhas que você já conhece.
A observabilidade trata do outro tipo de pergunta. Por que os tempos de conclusão de jobs em um pod de GPU atrasaram toda tarde durante uma semana? Num caso assim, a resposta costuma estar em três lugares ao mesmo tempo: o log de manutenção da unidade de refrigeração, as temperaturas de entrada por rack e os eventos de throttling térmico nos logs do BMC dos servidores. Nenhum alerta isolado conecta isso. Um ambiente observável permite que um engenheiro faça isso em minutos em vez de dias.
Logs, métricas e traces: o que cada sinal diz
Métricas dizem quanto, logs dizem o que aconteceu e traces dizem onde o tempo foi gasto em uma cadeia de componentes. Cada um tem um ponto cego, e por isso um data center precisa dos três mais o contexto físico.
Sinal | O que é | Exemplos em data center | Melhor para | Ponto cego |
|---|---|---|---|---|
Métricas | Medições numéricas amostradas ao longo do tempo | Temperatura de entrada do rack, amperes da PDU, RPM de ventoinha, erros de interface, potência óptica de recepção | Tendências, limites, planejamento de capacidade | Pouco contexto sobre por que um valor mudou |
Logs | Registros de eventos com carimbo de hora | Syslog de switches, logs de eventos do BMC, alarmes do BMS, registros de acesso por crachá | Sequência de eventos, perícia | Alto volume, formatos inconsistentes |
Traces | O caminho de uma requisição entre serviços | Caminho de I/O de storage, chamadas de API por um balanceador, etapas de um job distribuído | Atribuição de latência entre componentes | Para na fronteira do software |
Métricas
As métricas são baratas de armazenar e fáceis de plotar. O problema começa com escala e amostragem. Leituras ópticas por porta em milhares de portas criam muitas séries temporais, e um intervalo de coleta de cinco minutos vai diluir uma queda de energia de 40 segundos ou um microburst que descartou pacotes. Escolha o intervalo com base na falha que você quer enxergar, não no que o modelo padrão traz.
Logs
Os logs carregam o contexto mais rico e os dados mais bagunçados. O problema mais comum que vemos são relógios não sincronizados. Se o relógio do BMS se desvia três minutos do equipamento de rede, uma correlação que deveria ser óbvia desaparece. A sincronização de horário entre sistemas de instalação e de TI é um trabalho chato que compensa em toda investigação.
Traces
O tracing nasceu no software distribuído e, em um data center, importa para os serviços que rodam sobre a infraestrutura. Um trace pode mostrar que uma chamada de storage passou a maior parte do tempo esperando um nó. Ele não diz que o óptico de uplink desse nó está esquentando. Essa passagem, dos traces de aplicação para a telemetria física, é onde muitas investigações emperram.
Onde o OpenTelemetry se encaixa na observabilidade de data center?
O OpenTelemetry é um padrão aberto e neutro em relação a fornecedores para gerar, coletar e exportar telemetria. Não é um produto de monitoramento nem um banco de dados.
O projeto se descreve como um framework e um conjunto de ferramentas de observabilidade para dados de telemetria “como traces, métricas e logs”, e afirma com clareza que “não é, em si, um backend de observabilidade”. É um projeto da Cloud Native Computing Foundation formado pela fusão do OpenTracing com o OpenCensus. Seu valor prático é um protocolo comum (OTLP) e convenções semânticas, de modo que um nome de host ou de serviço signifique o mesmo entre ferramentas. O OpenTelemetry Collector também pode ser estendido com receptores para fontes de dados personalizadas.
Para os sinais do lado de TI, adotar o OpenTelemetry é um padrão sensato. Seja realista, porém, quanto ao lado das instalações. A maior parte dos dados de energia e refrigeração ainda chega por SNMP, Modbus, BACnet, Redfish ou APIs de fabricantes, então espere uma camada de tradução. O OpenTelemetry padroniza como a telemetria se move. Ele não corrige nomes de rack inconsistentes nem um mapa de cabos defasado em duas migrações.
Por que a camada física é a lacuna habitual da observabilidade
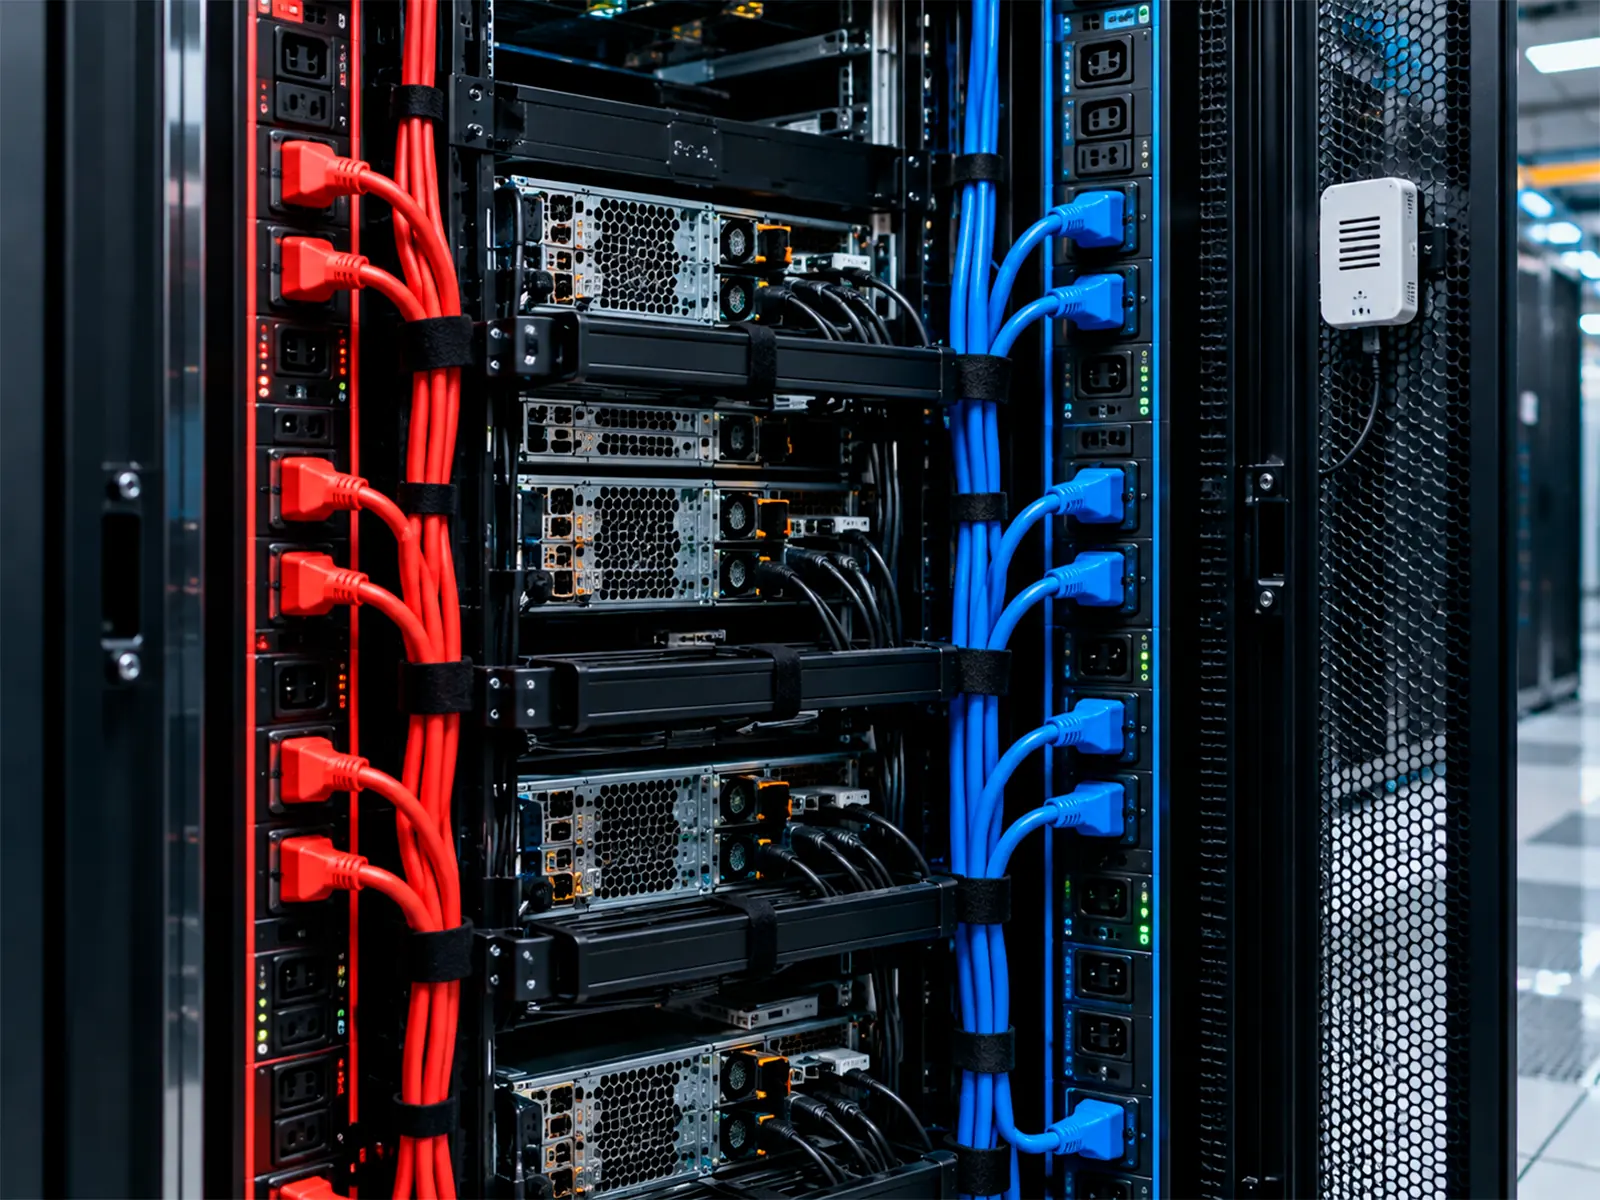
A telemetria física está dividida entre DCIM, BMS e planos de gerenciamento de dispositivos, e os registros que dão contexto a ela (elevações de rack, mapas de portas, rotas de cabos) ficam defasados no instante em que alguém move um jumper sem atualizá-los.
Os sinais físicos que vale coletar:
- Energia: medição de UPS, PDU e busway, estados de disjuntores, monitoramento de baterias.
- Ambiente: temperaturas de entrada e exaustão, umidade, pressão diferencial, detecção de vazamentos.
- Hardware de computação: dados da controladora de gerenciamento da placa-mãe via Redfish ou IPMI, incluindo status de PSU, velocidades de ventoinha e contagens de erros de memória.
- Ópticos: monitoramento de diagnóstico digital em transceptores (temperatura, corrente de polarização do laser, potência de transmissão e recepção), definido para módulos SFP no SFF-8472 e, para formatos mais novos de alta densidade, no CMIS.
- Plantas de fibra: perda de inserção e linhas de base de OTDR registradas na instalação.
- Registros de localização: elevações de rack do DCIM, mapas de patch panels, etiquetas de ativos.
A parte de conectividade merece atenção. A Análise Anual de Interrupções 2026 do Uptime Institute relata que as interrupções ligadas a fibra e conectividade estão aumentando e têm mais probabilidade de resultar em interrupções prolongadas.
Telemetria que aponta para o lugar errado
O modo de falha que mais encontramos não é telemetria ausente. É telemetria apontando para o local errado. Um alerta mostra a potência de recepção caindo em uma porta de um switch leaf. O registro do DCIM diz que essa porta vai para a posição 14 de um painel na fileira ao lado. Durante uma migração o jumper foi reconectado à posição 16, e ninguém atualizou o registro. O técnico limpa e inspeciona o conector errado, o ticket volta e um conserto curto vira um segundo despacho.
É por isso que o que as equipes de campo precisam das ferramentas de DCIM importa tanto quanto a plataforma de monitoramento, e por que os modelos de detecção de anomalias só são tão úteis quanto os dados de localização por trás deles.
Como construir uma prática de observabilidade de data center
Comece pela verdade física, depois instrumente e depois correlacione. Equipes que invertem a ordem acabam com painéis afiados construídos sobre o mapa errado.
- Estabeleça primeiro a verdade física. Audite elevações de rack, mapas de portas, atribuições de cabos de energia A/B e etiquetas de ativos contra o que está de fato instalado.
- Decida quais perguntas importam. Liste os incidentes que você quer diagnosticar mais rápido e os níveis de serviço sobre os quais reporta. Essa lista define o que instrumentar.
- Instrumente cada camada. Instalação, energia, computação, rede, ópticos e serviços, cada uma com um intervalo de amostragem compatível com seus modos de falha.
- Use um único esquema de identificadores. Site, hall, fileira, rack, posição em U e porta devem aparecer iguais na etiqueta do cabo, no DCIM e no alerta. A rotulagem TIA-606 é uma boa base.
- Sincronize os relógios entre os sistemas de instalação e de TI.
- Correlacione antes de alertar. Agrupe sintomas por topologia e tempo para que uma causa raiz produza um incidente. Nosso guia sobre o que é AIOps e do que precisa cobre essa etapa com mais profundidade.
- Feche o ciclo com o campo. Todo despacho deve devolver evidências (fotos, números de série, leituras ópticas) e atualizar o registro em que se baseou.
O passo 7 é o que a maioria dos programas pula. É também o que mantém os passos 1 e 4 verdadeiros um ano depois.
O que uma stack de observabilidade deve entregar a um técnico de campo?
Um bom alerta dá ao técnico quatro coisas: uma localização exata, o sintoma, a evidência e um escopo de trabalho seguro. Se qualquer uma faltar, o tempo no local vai para a descoberta em vez do reparo.
Checklist de um incidente pronto para despacho:
- Localização exata: site, hall, fileira, rack, posição em U e porta.
- Sintoma com sua janela de tempo e as leituras que o dispararam.
- Identidade do ativo: modelo, número de série e se contém dados.
- Pré-requisitos de acesso: crachá, acompanhante, janela de mudança, aprovações do cliente.
- Sobressalentes no local ou em trânsito, com rastreamento.
- Critério de conclusão: a leitura que prova o reparo, como a potência de recepção de volta à faixa especificada do óptico.
Os operadores que acertam essa passagem vêem o retorno descrito na nossa análise de ROI de uptime de data center: menos visitas repetidas e registros de incidentes mais limpos. Ela também produz os dados as-built precisos de que um gêmeo digital de data center depende.
Como a Hype Telecom ajuda
A Hype Telecom não vende software de observabilidade. Trabalhamos no lado físico que o torna preciso. Nossas equipes qualificadas e validadas instalam racks e cabeamento estruturado alinhados à BICSI, etiquetam seguindo um esquema consistente, testam e documentam links de fibra e registram evidências fotográficas no encerramento, de modo que os registros usados pela sua plataforma correspondam ao piso.
Quando os alertas disparam, nossos serviços de Smart Hands e Manutenção de Primeira Linha (FLM) colocam no local técnicos com credenciais CompTIA Server+, Network+ e A+, com um histórico de resposta emergencial em menos de 4 horas em mais de 50 sites ativos nos EUA e no Brasil — um compromisso de chegada, com SLAs configurados por contrato — e uma taxa de 95% de resolução na primeira visita. Nossa equipe de coordenação devolve evidências de fechamento, incluindo fotos, números de série e leituras, de modo que cada despacho deixe os seus registros mais precisos do que os encontrou.
Se a sua telemetria continua mandando técnicos para a porta errada, agende uma conversa de 15 minutos com um especialista em implantação para revisar como os seus registros físicos e o fluxo de campo se conectam.
Perguntas frequentes
O monitoramento verifica condições definidas com antecedência, como uma UPS na bateria ou um link fora do ar. A observabilidade permite que os engenheiros investiguem problemas que ninguém previu, correlacionando métricas, logs, traces e telemetria física entre camadas. Você precisa dos dois. O monitoramento capta falhas conhecidas com rapidez, e a observabilidade encurta a investigação quando a causa envolve refrigeração, energia, hardware e rede ao mesmo tempo.
Os três tipos clássicos de sinal são métricas, logs e traces. Métricas são medições numéricas ao longo do tempo, logs são registros de eventos com carimbo de hora e traces acompanham uma requisição entre serviços. Em um data center, uma quarta categoria importa tanto quanto: a telemetria da camada física e os registros de localização, como energia, temperatura, níveis ópticos, elevações de rack e mapas de portas.
O OpenTelemetry padroniza como traces, métricas e logs são gerados, coletados e exportados, e seu Collector pode ser estendido com receptores para fontes personalizadas. A maioria dos equipamentos de energia e refrigeração ainda fala SNMP, Modbus, BACnet, Redfish ou APIs de fabricantes, então os dados de instalação costumam precisar de uma camada de tradução. O OpenTelemetry não substitui um backend nem corrige registros de ativos imprecisos.
O DCIM guarda o contexto de localização que transforma uma leitura em uma ação: qual rack, qual posição em U, qual porta do painel. Se esse registro está defasado, um alerta preciso ainda manda um técnico ao lugar errado. Manter o DCIM atualizado com auditorias e atualizações pós-despacho é uma das formas mais baratas de fazer um investimento em observabilidade compensar.
Atualize os registros como parte de cada mudança, e não depois. Além disso, muitos operadores fazem auditorias periódicas por amostragem comparando o DCIM com o piso, com frequência definida pela quantidade de mudanças de cada hall. Áreas de alta rotatividade, como expansões de IA ou zonas de migração, precisam de verificações mais frequentes do que halls estáveis. Acompanhe a taxa de divergência ao longo do tempo para decidir.