
Respuesta rápida: Un runbook de escalamiento para data center es un procedimiento escrito que indica, para cada prioridad de incidente, a quién se notifica, en qué orden, en cuánto tiempo y qué información acompaña el escalamiento. Para armarlo, defina P1 a P4 por impacto en el negocio, mapee árboles de contacto y presupuestos de tiempo para cada nivel y pruebe el resultado en simulacros antes de que una caída real lo haga por usted.
A las 3:40 de la mañana, la diferencia entre un incidente de 20 minutos y uno de cuatro horas rara vez es la habilidad técnica. Es si la persona que ve la alarma sabe exactamente a quién llamar, qué decirle y cuánto esperar antes de llamar a otra persona. Para eso sirve un runbook de escalamiento.
Esta guía es para gerentes de operaciones y líderes de incidentes responsables de la respuesta en una o varias instalaciones. Cubre cómo definir niveles de prioridad, qué va en un runbook, cómo fijar presupuestos de tiempo y árboles de contacto y cómo mantener vivo el documento una vez escrito. Incluye una tabla de runbook de ejemplo que puede adaptar.
Una observación antes de empezar. La mayoría de los runbooks que recibimos de nuevos clientes describe bien la ruta de escalamiento e ignora la parte física: llevar a una persona calificada a la jaula correcta, con la pieza correcta y con una credencial que funcione. Aquí le damos a esa parte más espacio que la mayoría de las plantillas.
¿Qué es un runbook de escalamiento para data center?
Es la guía paso a paso que siguen los responsables una vez detectado un incidente, desde su clasificación hasta su cierre. Se diferencia de una matriz de escalamiento, que es solo la tabla de a quién contactar, y de un plan de respuesta a incidentes, que fija políticas.
Un runbook de escalamiento para data center es la guía documentada que indica a los responsables cómo clasificar un incidente por prioridad, a quién involucrar en cada etapa, cuánto puede durar cada etapa antes de escalar más y qué evidencia debe entregarse en cada paso.
El runbook se ubica entre el monitoreo y las personas que resuelven los problemas. Las alertas llegan del equipo de monitoreo del operador, del DCIM o del BMS. El runbook las convierte en decisiones: despachar un técnico de campo, abrir un caso con el fabricante, despertar al ingeniero de guardia, avisar a los clientes.
¿Cómo definir incidentes P1, P2, P3 y P4?
Defina la prioridad por impacto en el negocio y urgencia, no por el equipo que dio la alarma. Un ventilador con falla y una fuente con falla pueden ser P3 o P1 según la redundancia, la carga y lo que ya esté degradado.
Prioridad | Definición | Ejemplos en la capa física | A quién se involucra |
|---|---|---|---|
P1 crítico | Servicio caído o pérdida inminente de servicio para producción o clientes | Pérdida de ambas alimentaciones de un rack; varios hosts caídos en un clúster de producción; falla de refrigeración con temperatura de entrada en aumento en una sala | Líder del incidente, ingeniería de guardia, despacho de campo inmediato, TAC del fabricante, gerencia, comunicación con clientes |
P2 alto | Servicio degradado o redundancia perdida en una ruta crítica | Una fuente con falla en un servidor de producción con doble alimentación; una ruta de fibra caída en un par protegido; uno de dos uplinks caído | Ingeniería de guardia, despacho de campo, caso con el fabricante abierto |
P3 medio | Impacto limitado, redundancia intacta | Un disco con falla en un arreglo con hot spare; un ventilador con falla en un chasis con los demás a velocidad normal | Despacho de campo en horario hábil o en la siguiente visita programada |
P4 bajo | Sin impacto; solicitud o trabajo planificado | Corrección de etiquetas, ordenamiento de cables, cambios de hardware planificados, auditorías | Programado por la cola normal de tickets |
Dos reglas hacen que estas definiciones funcionen en la práctica. Primero, permita subir de nivel: un P3 pasa a P2 en el momento en que la redundancia restante está en riesgo. Segundo, deje que la persona más cercana al problema suba la prioridad sin aprobación, y exija aprobación solo para bajarla.
¿Qué va en un runbook de escalamiento para data center?
Un runbook utilizable tiene diez partes. Cada una debe caber en una página o menos, porque nadie lee un documento de 40 páginas durante una caída.
- Alcance: sitios, salas, sistemas y clientes cubiertos.
- Definiciones de prioridad: la tabla anterior, adaptada a su entorno.
- Checklist de triaje: las cinco primeras preguntas a responder antes de escalar (qué alarmó, desde cuándo, qué está afectado, si la redundancia está intacta, si alguien ya está trabajando en ello).
- Árbol de contactos: roles y suplentes para cada prioridad, con disponibilidad 24/7 confirmada.
- Presupuestos de tiempo: cuánto puede durar cada etapa antes de que se dispare el siguiente escalamiento.
- Paquete de traspaso: la información que debe acompañar cada escalamiento.
- Procedimiento de despacho de campo: cómo solicitar ayuda en sitio, incluidos acceso y piezas.
- Plantillas de comunicación: actualizaciones internas, avisos a clientes y texto para la página de estado.
- Traspaso a seguridad: cuándo y cómo derivar al proceso de incidentes de seguridad.
- Cierre y revisión: criterios para bajar la prioridad, evidencia de cierre y el disparador de una revisión posincidente.
Árboles de contacto que funcionan a las 3 de la mañana
Escriba los árboles de contacto por rol, no por nombre, y liste al menos un titular y un suplente para cada rol. Los nombres cambian cada trimestre. Los roles no. Incluya a las personas fuera de su organización que formarán parte de un P1 real: la mesa de operaciones del proveedor de colocation, la línea de soporte del fabricante de hardware, el carrier y el equipo de coordinación de su proveedor de servicios de campo. Luego llame a cada número una vez por trimestre. Un árbol de contactos que no se ha probado es una suposición.
Cómo fijar presupuestos de tiempo de escalamiento
Un presupuesto de tiempo es el tiempo máximo que puede durar una etapa antes de que el siguiente escalamiento se dispare automáticamente. Fije presupuestos por prioridad y por etapa, y haga que el escalamiento sea automático cuando un presupuesto venza. Nadie debería tener que decidir a las 4 de la mañana si ya es hora de despertar a alguien.
La tabla siguiente es un runbook de ejemplo para un evento de energía P1. Los tiempos son solo valores iniciales ilustrativos. Fije los suyos a partir de sus SLA, sus contratos y lo que su equipo realmente puede sostener; nuestro artículo sobre referencias de tiempo de respuesta de SLA en data center explica cómo se construyen esos números contractuales.
Paso | Acción | Responsable | Presupuesto de tiempo ilustrativo | Escalar a, si se excede |
|---|---|---|---|---|
1 | Reconocer la alarma, abrir ticket P1 | Monitoreo de turno | 5 min desde la alarma | Líder del incidente |
2 | Checklist de triaje completado, impacto confirmado | Líder del incidente | 15 min desde la alarma | Gerente de ingeniería |
3 | Despacho de campo solicitado con el paquete de traspaso | Líder del incidente | 15 min desde la alarma | Contacto de escalamiento del proveedor de campo |
4 | Caso con el fabricante abierto, severidad 1 | Ingeniero de guardia | 30 min desde la alarma | Gerente de cuenta del fabricante |
5 | Técnico en sitio, primera actualización con fotos | Técnico de campo | Según la meta contratada de llegada | Gerente de turno del proveedor de campo |
6 | Aviso a clientes enviado | Responsable de comunicaciones | 30 min desde la alarma, luego cada 60 min | Director de operaciones |
7 | Servicio restablecido, el monitoreo lo confirma | Líder del incidente | Se registra, sin presupuesto | No aplica |
8 | Revisión posincidente programada | Líder del incidente | Dentro de 2 días hábiles | Director de operaciones |
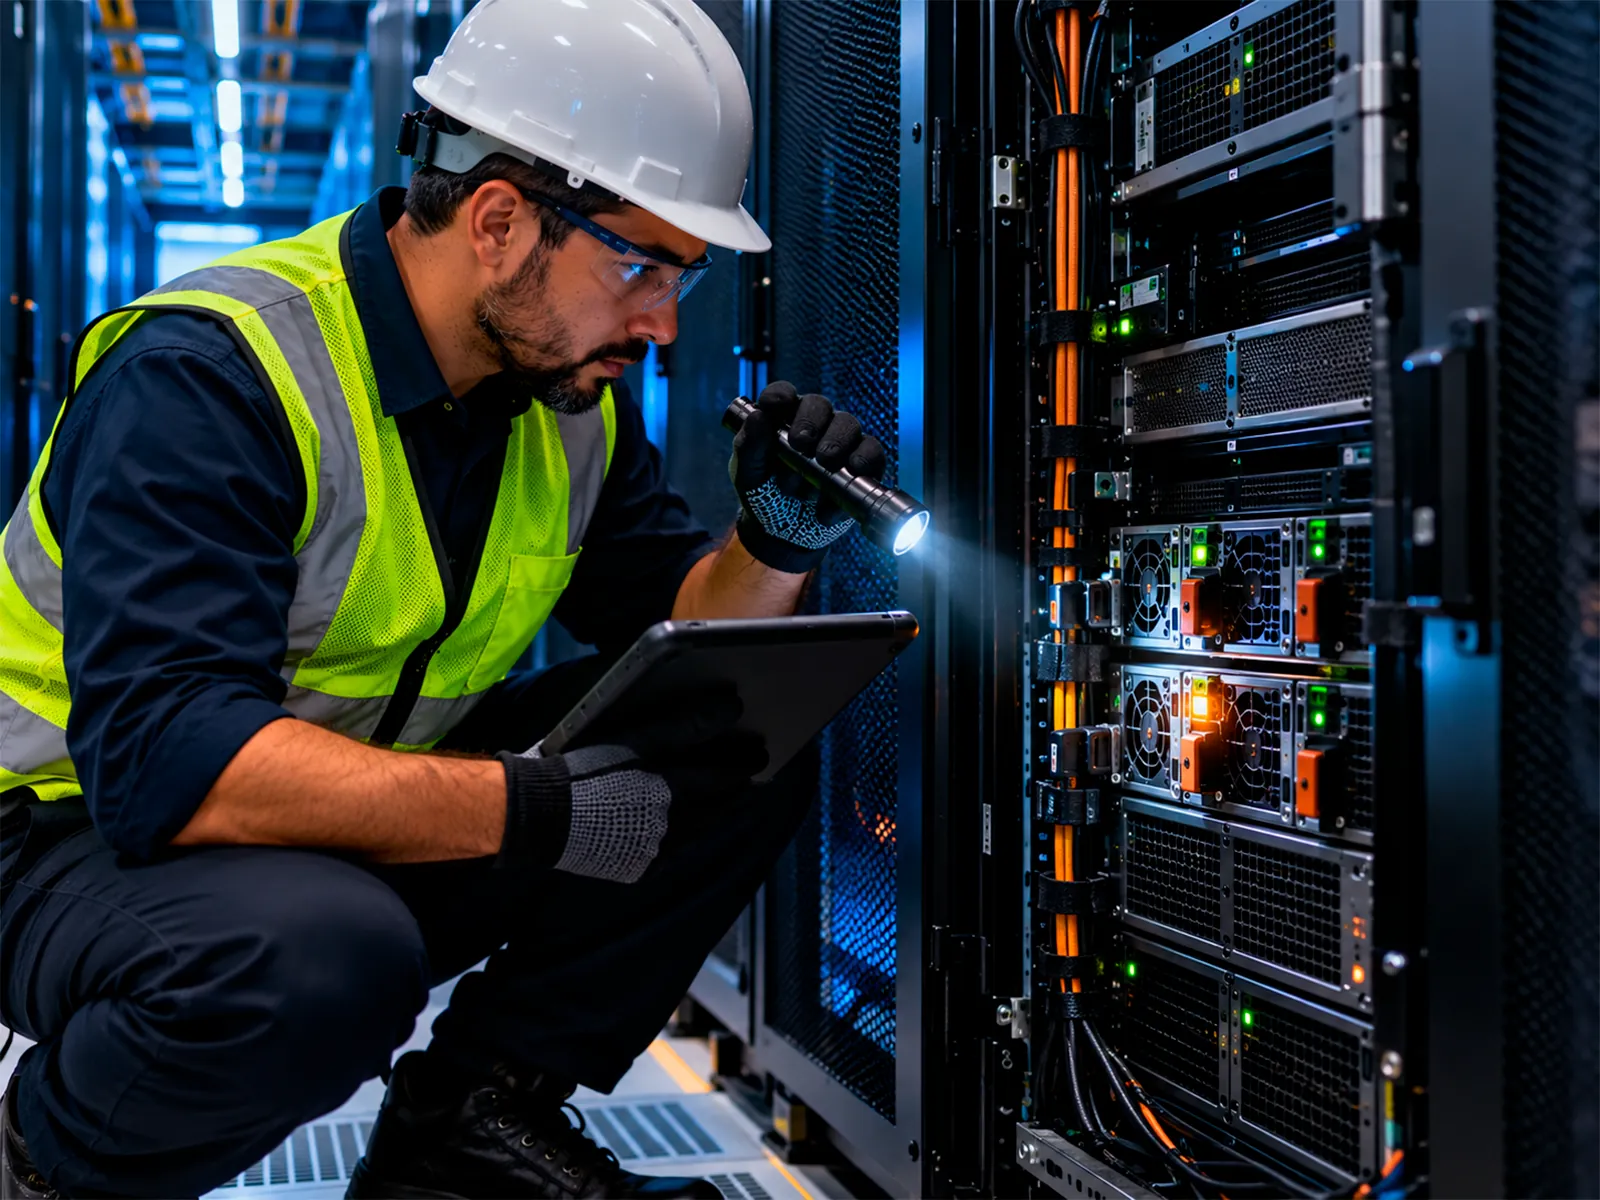
Observe que el paso 5 depende de algo que el runbook no controla por sí solo: si el técnico puede entrar al edificio. Si el sitio exige solicitar la credencial con 24 horas de anticipación, su meta de llegada para P1 es ficción, salvo que haya un grupo de técnicos preinscrito. Resuelva eso antes de publicar el runbook.
¿Qué información debe acompañar un escalamiento?
Cada escalamiento debe llevar el mismo paquete de traspaso, para que la siguiente persona nunca tenga que pedir contexto. Cuando un técnico de campo recibe un ticket incompleto, los primeros 20 minutos en sitio se van en redescubrir lo que el equipo de monitoreo ya sabía.
El paquete debe incluir:
- ID y prioridad del ticket, con la hora de la primera alarma.
- Ubicación exacta: sitio, sala, fila, rack y posición en U.
- Hostname, modelo y número de serie del equipo.
- Síntomas, texto de la alarma y líneas de log relevantes.
- Acciones ya realizadas y por quién.
- Estado del acceso: credencial aprobada, escolta reservada, ubicación de la llave de la jaula.
- Estado de las piezas: repuesto en sitio, en tránsito o aún no pedido.
- Aprobador de acciones de energía u otros pasos de riesgo.
Para saber más sobre cómo se mueven los escalamientos entre el equipo de monitoreo del operador, los técnicos de campo y el soporte del fabricante, vea nuestro artículo sobre rutas de escalamiento en data centers de gran escala.
Cuándo un incidente físico se convierte en un incidente de seguridad
Algunos incidentes físicos también son eventos de seguridad: una jaula encontrada abierta, un disco faltante en un envío de RMA, un equipo apagado por alguien que no debería tener acceso. El runbook debe indicar quién decide que un incidente requiere la participación de seguridad y cómo se hace el traspaso. La NIST SP 800-61 Rev. 3, publicada en abril de 2025, es la referencia federal vigente de Estados Unidos para respuesta a incidentes de ciberseguridad y un buen ancla para ese traspaso.
Cómo probar y mantener el runbook
Pruébelo con ejercicios de mesa y simulacros reales, y actualícelo después de cada P1 y P2. Un runbook que solo se lee durante los incidentes estará equivocado durante los incidentes.
La calidad de los procedimientos no es un tema de papeleo. En su Annual Outage Analysis 2025, el Uptime Institute informó que casi el 40% de las organizaciones sufrió una caída grave causada por error humano en los tres años anteriores, y que el 85% de esos incidentes se debió a que el personal no siguió los procedimientos o a fallas en los propios procedimientos.
Tres hábitos ayudan:
- Haga un ejercicio de mesa de un escenario P1 cada trimestre, incluidos los pasos de despacho de campo y acceso.
- Después de cada P1 y P2, compare los tiempos reales de cada etapa con los presupuestos y corrija el paso que se excedió. Nuestra guía de análisis de causa raíz en data centers explica cómo hacer esa revisión sin buscar culpables.
- Asigne un responsable del runbook y ponga una fecha de revisión en la primera página.
Las prácticas de nuestra guía de buenas prácticas de First Line Maintenance (FLM) cubren el lado de campo de la misma disciplina: briefings antes del despacho, preparación de piezas y evidencia de cierre.
Cómo ayuda Hype Telecom
Hype Telecom ofrece soporte de campo de Smart Hands y FLM con disponibilidad 24/7 en más de 50 sitios activos en Estados Unidos y Brasil, donde mantenemos un historial de respuesta de emergencia en menos de 4 horas (un compromiso de llegada, con SLA configurados por contrato) y 95% de resolución en la primera visita. Nuestro equipo de coordinación se integra a su runbook de escalamiento como contacto nombrado: recibe el paquete de traspaso, confirma el estado del acceso y las piezas, despacha un técnico y devuelve actualizaciones documentadas con fotos al líder del incidente. Los técnicos tienen capacitación OSHA de 10 y 30 horas y certificaciones CompTIA Server+, Network+ o A+. Conozca más sobre cómo funciona en nuestra página de coordinación de operaciones.
Si quiere saber si su cobertura de campo actual realmente puede cumplir los tiempos de llegada de su runbook, solicite una evaluación gratuita de cobertura.
Preguntas frecuentes
Una matriz de escalamiento es una tabla de a quién contactar para cada prioridad y nivel. Un runbook es el procedimiento completo que la rodea: cómo clasificar el incidente, qué revisar primero, presupuestos de tiempo para cada etapa, la información que acompaña cada escalamiento, plantillas de comunicación y criterios de cierre. La matriz es una sección de un buen runbook.
Un P1 es un incidente en el que el servicio de producción está caído o la pérdida de servicio es inminente, por ejemplo, la pérdida de ambas alimentaciones de un rack, varios hosts caídos en un clúster de producción o una falla de refrigeración con temperatura de entrada en aumento. La prioridad debe reflejar el impacto en el negocio y la urgencia, no solo el equipo que dio la alarma.
Revíselo después de cada incidente P1 y P2 y, fuera de eso, al menos una vez por trimestre. Los árboles de contacto se desactualizan más rápido, así que llame a cada número en la revisión trimestral. Cualquier cambio de sitios, fabricantes, proveedores de campo o SLA también debe generar una actualización, y un responsable nombrado debe rendir cuentas por mantener el documento al día.
Un paquete de traspaso completo: ID y prioridad del ticket, ubicación exacta hasta el rack y la posición en U, modelo y número de serie del equipo, síntomas y horas de las alarmas, acciones ya realizadas, estado del acceso, estado de las piezas y quién puede aprobar pasos de riesgo como reinicios. Con eso, el técnico empieza a resolver el problema al llegar, en lugar de reconstruirlo.
Normalmente sí, pero no de inmediato. Un P3 tiene impacto limitado y redundancia intacta, así que suele atenderse en horario hábil o en la siguiente visita programada. El runbook debe fijar la antigüedad máxima de un P3 abierto y subirlo automáticamente a P2 si la redundancia restante entra en riesgo.

